Złośliwy kod na stronie internetowej nie musi pochodzić z serwera jej właściciela. Może zostać dostarczony przez zewnętrzny skrypt, bibliotekę lub inny komponent, z którego korzysta witryna. Przejęcie takiego elementu może doprowadzić do kradzieży danych klientów. Dlatego w monitorowaniu bezpieczeństwa strony warto zwracać uwagę nie tylko na jej zawartość, ale również na adresy URL, które są wykorzystane do wyświetlania strony.
Monit24 wIDS wykorzystuje model Machine Learning do analizy adresów URL elementów strony i wskazywania anomalii, które mogą świadczyć o nieoczekiwanych zmianach lub potencjalnych zagrożeniach.
Dlaczego adresy URL zasobów strony mają znaczenie dla bezpieczeństwa?
Współczesne serwisy internetowe rzadko składają się wyłącznie z zasobów przechowywanych na własnych serwerach. Witryny korzystają z zewnętrznych bibliotek, skryptów, widgetów, narzędzi analitycznych, reklam i innych komponentów. Przeglądarka pobiera je z adresów URL wskazanych w kodzie strony.
Każdy taki zasób jest częścią środowiska, w którym funkcjonuje witryna. Jeśli jego adres zostanie zmieniony albo zacznie prowadzić do niebezpiecznej lokalizacji, użytkownicy mogą zostać narażeni na kontakt ze złośliwą zawartością.
Problem nie zawsze jest widoczny na pierwszy rzut oka. Strona może nadal poprawnie się wyświetlać i odpowiadać na żądania HTTP, mimo że jeden z wykorzystywanych przez nią zasobów pochodzi z niepożądanego źródła.
Zewnętrzne zasoby jako potencjalny punkt wejścia
Korzystanie z zewnętrznych komponentów ułatwia rozwój serwisów i pozwala wykorzystywać gotowe rozwiązania. Jednocześnie tworzy dodatkowe zależności, nad którymi właściciel strony nie zawsze ma pełną kontrolę.
Zagrożenie może pojawić się na przykład wtedy, gdy:
- zewnętrzny dostawca zostanie zaatakowany, a udostępniany przez niego skrypt zmodyfikowany;
- w kodzie strony pojawi się odwołanie do zasobu z nieznanej lub nieoczekiwanej domeny;
- atakujący uzyska dostęp do serwisu i zmieni adresy zasobów wykorzystywanych przez witrynę;
- legalna domena zostanie przejęta i zacznie udostępniać pliki lub treści związane z działalnością przestępczą.
W takich sytuacjach istotne jest nie tylko to, jaki kod lub treść znajduje się na stronie, ale również to, skąd przeglądarka je pobiera.
Co może się stać, gdy element na stronie pochodzi z podejrzanego adresu?
Niepożądany link może zostać wykorzystany do dostarczenia złośliwego kodu, wyświetlenia fałszywych komunikatów, przekierowania użytkownika albo przechwycenia informacji wprowadzanych na stronie.
Szczególnie niebezpieczne są sytuacje, w których atakujący wykorzystuje zaufanie użytkowników do znanej witryny. Osoba odwiedzająca serwis może nie spodziewać się, że jeden z jego elementów prowadzi do infrastruktury kontrolowanej przez przestępców.
Wiąże się to również z tzw. third-part apps, o których pisaliśmy w lutym b.r.
Jak atakujący wykorzystują zewnętrzne zasoby i przejęte strony?
Nie każdy atak wymaga stworzenia nowej domeny i budowania jej wiarygodności od zera. Cyberprzestępcy mogą próbować wykorzystać istniejące strony, ich infrastrukturę oraz zaufanie, jakim darzą je użytkownicy.
Podmiana zewnętrznego skryptu
Jednym ze scenariuszy jest przejęcie infrastruktury dostawcy zewnętrznego. Jeśli strona korzysta z jego skryptu lub innego komponentu, zmiana zawartości udostępnianej pod dotychczasowym adresem może wpłynąć również na witrynę klienta.
Adres URL może pozostać bez zmian, mimo że dostarczany pod nim zasób zawiera już złośliwy kod. Właściciel serwisu może więc nie zauważyć problemu, jeśli kontroluje wyłącznie własną infrastrukturę, pomijając zależności od zewnętrznych dostawców.
Wykorzystanie przejętej strony do hostowania niechcianych treści
Inny scenariusz zaczyna się od uzyskania przez atakującego dostępu do witryny organizacji. Może to być efekt przejęcia konta administratora, wykorzystania podatności w systemie CMS, nieaktualnej wtyczki lub niewłaściwie zabezpieczonego panelu zarządzania.
Po uzyskaniu dostępu przestępca może wykorzystać strukturę serwisu do umieszczania treści, które nie mają związku z działalnością właściciela. Mogą to być na przykład:
- fałszywe strony logowania podszywające się pod banki lub popularne usługi;
- strony wyłudzające dane osobowe i informacje płatnicze;
- pliki wykorzystywane do rozpowszechniania złośliwego oprogramowania;
- treści reklamujące oszukańcze usługi lub produkty.
Następnie atakujący może rozpowszechniać adresy tych stron za pomocą wiadomości e-mail, SMS-ów, mediów społecznościowych lub reklam. Ofiara widzi adres należący do prawdziwej domeny, która może być jej znana i wcześniej uznawana za wiarygodną.
To poważny problem również dla właściciela serwisu. Jego domena zaczyna być wykorzystywana w działaniach przestępczych, mimo że nie ma on z nimi nic wspólnego. Może to prowadzić do utraty zaufania użytkowników, ostrzeżeń wyświetlanych w przeglądarkach, problemów z widocznością w wyszukiwarkach oraz kosztów związanych z usunięciem skutków włamania.
Google opisuje takie scenariusze w dokumentacji dotyczącej stron phishingowych i treści wprowadzających w błąd. Atakujący mogą przejmować legalnie działające witryny, dodawać do nich nowe podstrony lub wykorzystywać osadzone zasoby do rozpowszechniania treści służących wyłudzaniu danych.
Atak na Ticketmaster: złośliwy skrypt przechwytywał dane klientów
W 2018 roku użytkownicy Ticketmaster padli ofiarą incydentu związanego ze złośliwym kodem umieszczonym w zewnętrznym komponencie wykorzystywanym przez serwis.
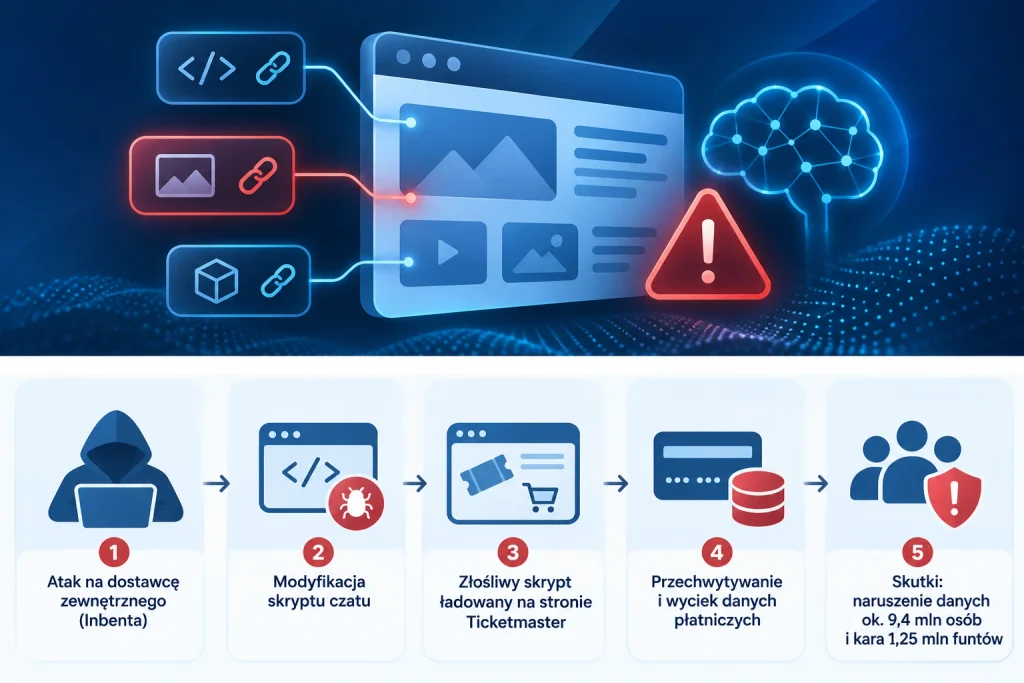
Ticketmaster korzystał z rozwiązania czatu dostarczanego przez firmę Inbenta. Skrypt obsługujący ten komponent był hostowany na infrastrukturze dostawcy, a sam chatbot został umieszczony również na stronie płatności Ticketmaster.
Atakujący uzyskali dostęp do infrastruktury Inbenta i zmodyfikowali kod JavaScript komponentu. Złośliwy skrypt umożliwiał przechwytywanie danych wprowadzanych przez użytkowników, w tym informacji dotyczących kart płatniczych, i przekazywanie ich atakującym.
W decyzji brytyjskiego organu ochrony danych Information Commissioner’s Office (ICO) wskazano adres zasobu, pod którym hostowany był skrypt czatu:
https://ticketmasteruk.inbenta.com/avatar/jsonp/inbenta.js
Atak rozpoczął się 10 lutego 2018 roku i trwał do 23 czerwca 2018 roku. W decyzji dotyczącej kary ICO uwzględniło naruszenie obejmujące okres od 25 maja do 23 czerwca 2018 roku.
Około 9,4 mln osób z Europejskiego Obszaru Gospodarczego zostało powiadomionych o potencjalnym naruszeniu. Według informacji przekazanych przez Barclays około 60 tys. danych kart płatniczych zostało przejętych w związku z incydentem. Monzo poinformowało natomiast o konieczności wymiany około 6 tys. kart w związku z oszustwami dotyczącymi transakcji Ticketmaster.
W listopadzie 2020 roku ICO nałożyło na Ticketmaster karę w wysokości 1,25 mln funtów, wskazując na niewystarczające środki bezpieczeństwa związane z ochroną danych klientów.
Co pokazuje ten przypadek?
Zasób pobierany z zewnętrznego adresu URL może stać się częścią ataku, nawet jeśli pierwotnie służył do obsługi legalnej funkcji serwisu. Właściciel witryny nie musi samodzielnie przechowywać danego skryptu, aby jego działanie miało wpływ na bezpieczeństwo użytkowników.
Przypadek Ticketmaster pokazuje również, że zagrożenie może dotyczyć tylko jednego z wielu komponentów strony. Cały serwis może działać poprawnie, podczas gdy konkretny zasób wykorzystywany na ważnym etapie obsługi klienta zostaje wykorzystany do przeprowadzenia ataku.
Nie oznacza to jednak, że sama analiza adresu URL automatycznie wykryłaby ten incydent. Jest to przykład ryzyka związanego z zewnętrznymi zasobami, a nie potwierdzenie skuteczności konkretnego mechanizmu detekcji.
Jak Monit24 wIDS wykrywa anomalie w adresach URL?
Monit24 wIDS analizuje adresy URL elementów strony internetowej z wykorzystaniem modelu Machine Learning. Mechanizm wskazuje anomalie, gdy adres danego elementu wydaje się podejrzany.
Dzięki temu monitoring obejmuje nie tylko samą zawartość witryny, ale również adresy, z których pochodzą jej poszczególne zasoby. Jest to dodatkowy sygnał bezpieczeństwa, który może pomóc zwrócić uwagę na nieoczekiwane lub nietypowe odwołania wykorzystywane przez serwis.
Warto pamiętać, że wykrycie anomalii nie jest równoznaczne z potwierdzeniem włamania ani złośliwego działania. Podejrzany adres powinien zostać zweryfikowany przez osobę odpowiedzialną za bezpieczeństwo lub utrzymanie serwisu.
Co zrobić po wykryciu podejrzanego adresu URL?
Pojawienie się anomalii powinno rozpocząć weryfikację zasobu i jego roli w działaniu strony. Nie każdy nietypowy adres oznacza atak, ale nie powinien też zostać zignorowany bez sprawdzenia.
W pierwszej kolejności warto:
- Ustalić, którego elementu dotyczy anomalia. Sprawdź, na której stronie występuje podejrzany adres i jaki zasób jest z nim powiązany.
- Zweryfikować domenę i źródło. Ustal, czy adres należy do znanego dostawcy, organizacji lub usługi wykorzystywanej przez serwis.
- Sprawdzić, czy dany element jest wykorzystywany świadomie. Porównaj go z dokumentacją techniczną strony i konfiguracją zewnętrznych komponentów.
- Zweryfikować ostatnie zmiany w serwisie. Sprawdź, czy adres nie pojawił się po aktualizacji, zmianie konfiguracji, wdrożeniu nowej funkcji lub nieautoryzowanej modyfikacji.
- Sprawdzić dostęp do systemu zarządzania stroną. Jeśli adres jest nieznany, zweryfikuj konta administratorów, uprawnienia i ostatnie operacje wykonane w CMS lub na serwerze.
- Przeanalizować inne sygnały. Zwróć uwagę, czy w tym samym czasie nie pojawiły się inne anomalie, na przykład zmiany w kodzie JavaScript, rekordach DNS, nagłówkach HTTP lub treści witryny.
Przykładowo, jeśli strona dotychczas korzystała ze skryptu dostawcy zewnętrznego, a po aktualizacji pojawiło się odwołanie do nieznanej domeny, administrator powinien ustalić, kto i dlaczego wprowadził tę zmianę. Warto również sprawdzić, czy nowy zasób jest wymagany do działania witryny i czy pochodzi z zaufanego źródła.
Jeśli potwierdzisz, że zasób jest niepożądany, usuń lub odłącz go w kontrolowany sposób, ustal przyczynę jego pojawienia się i zabezpiecz źródło problemu. W przypadku podejrzenia przejęcia strony konieczne może być również sprawdzenie pozostałych podstron, plików, kont i elementów infrastruktury.
Monitoruj adresy URL elementów swojej strony z Monit24 wIDS
Bezpieczeństwo serwisu internetowego zależy nie tylko od jego własnego kodu i treści. Znaczenie mają również zasoby, z których korzysta witryna, oraz adresy, pod którymi są one udostępniane.
Podejrzany adres może wskazywać na nieoczekiwaną zależność, zmodyfikowany komponent lub element infrastruktury wykorzystywany w ataku. Dlatego monitorowanie adresów URL zasobów stanowi wartościowe uzupełnienie obserwacji publicznie dostępnego serwisu.
Monit24 wIDS wykorzystuje Machine Learning do analizy adresów URL elementów strony i wskazywania anomalii, które warto zweryfikować. To dodatkowy sygnał pomagający szybciej zwracać uwagę na potencjalne zagrożenia i nieoczekiwane zmiany w zasobach wykorzystywanych przez witrynę.